GERM: как управлять репутацией бренда в ответах нейросетей и измерять результат
— по оценке 2 пользователей
20 октября, 11:53

29
0
10
Клиент спрашивает нейросеть, стоит ли покупать ваш продукт. В ответ получает: «Подходит для небольших команд, но пользователи отмечают сложности с поддержкой и возвратом средств». Бренд назван, сайт может стоять в источниках, а впечатление от компании уже складывается вокруг двух претензий.
Это пример ситуации, с которой работает GERM — управление репутацией бренда в генеративных ответах. Здесь важно выяснить, какие утверждения нейросеть сообщает о компании, чем их подтверждает и насколько они соответствуют текущей ситуации.
Разберу, как связать GERM с GEO и AEO, собрать репутационный мониторинг и оценить результат. Предлагаемые объемы проверок и сроки — пример организации работы. Это методика для проекта, а не отчет об эксперименте с доказанным ростом продаж.
GERM — Generative Engine Reputation Management: управление репутацией бренда в ответах генеративных систем. Его предмет — характеристики, факты, оценки и рекомендации, которые получает пользователь, когда спрашивает о компании или выбирает поставщика.
Чтобы не смешивать задачи, в этой статье использую следующие определения:
Один ответ может дать разные результаты по трем направлениям. Нейросеть рекомендует бренд без ссылки на его сайт — есть присутствие бренда по GEO. Цитирует статью компании, но рекомендует другого поставщика — сайт выступил источником по AEO. Называет компанию и повторяет устаревшее обвинение — возникает задача GERM.
Классический SERM при этом сохраняется: он работает с репутационным окружением в поисковой выдаче. Его результаты могут пересекаться с GERM, когда найденные страницы используются в генеративном ответе. Однако улучшение первой страницы поиска само по себе не доказывает, что описание бренда в нейросети изменилось.
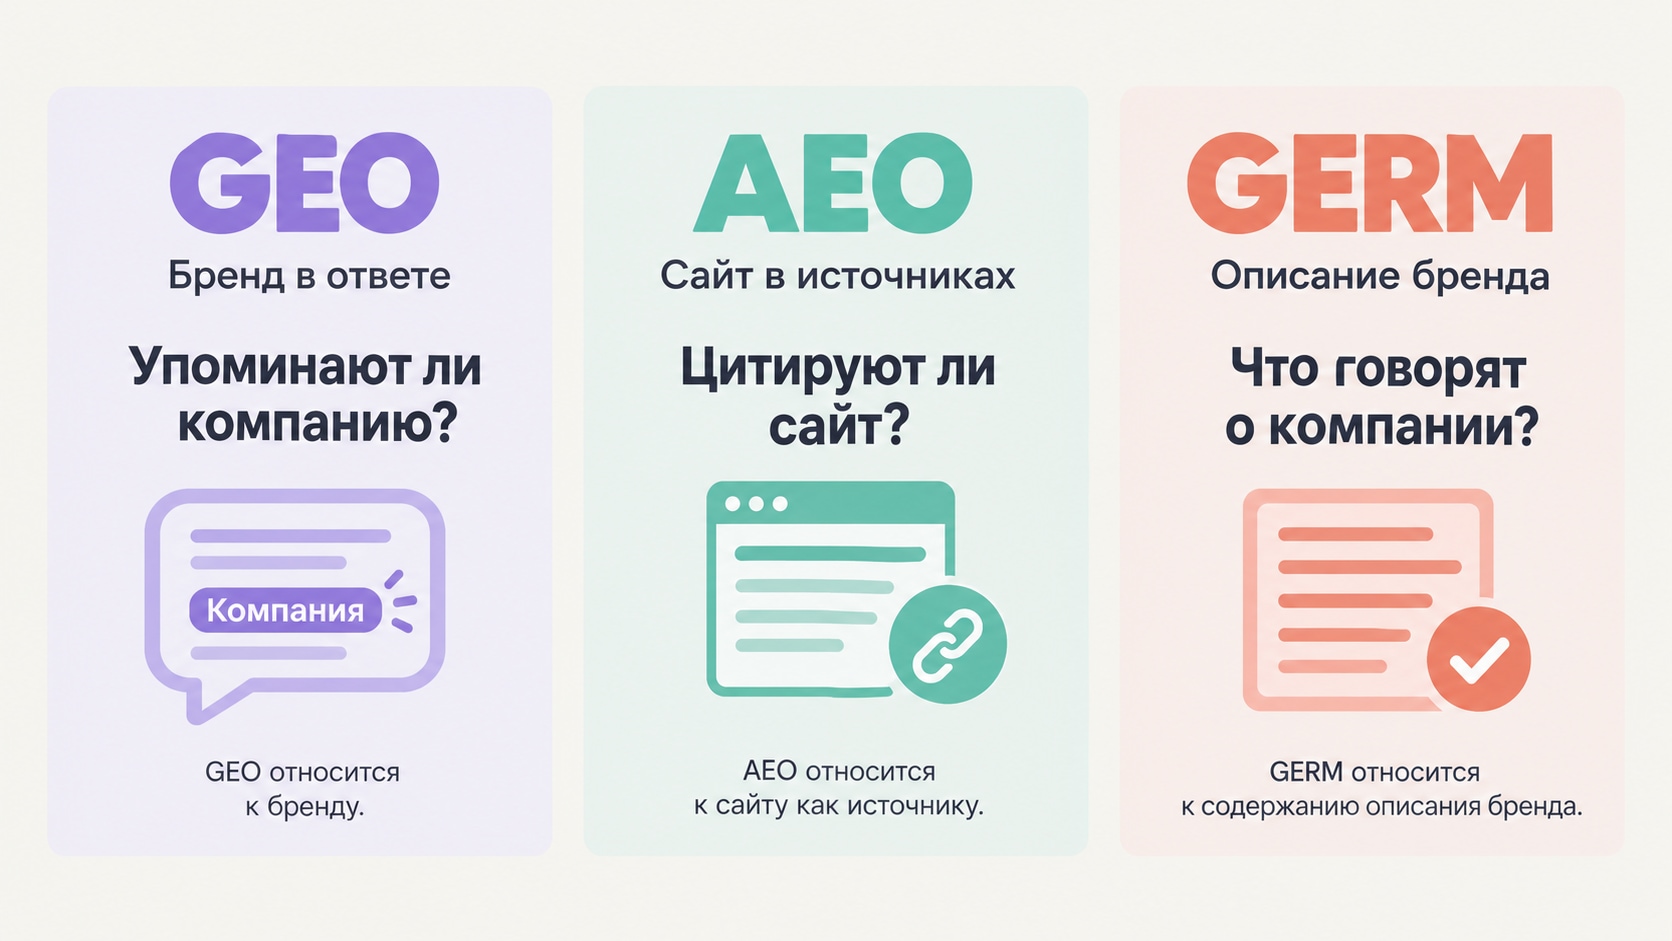
GEO, AEO и GERM оценивают разные стороны присутствия компании в ответах нейросетей.
Упоминание «компанию часто критикуют за непрозрачные условия» увеличивает видимость бренда так же, как рекомендация «подходит для вашей задачи». Для бизнеса смысл этих двух появлений различается.
Автоматическая тональность тоже не объясняет все. Фраза «сервис не поддерживает локальную установку» может выглядеть негативной, хотя это точное описание продукта. А доброжелательный ответ способен приписать компании функцию, которой у нее нет. После покупки такое обещание создаст проблему уже службе поддержки.
Поэтому я бы ставил GERM две связанные задачи: сокращать фактические искажения и добиваться соразмерного описания реальных достоинств и ограничений. Корректное указание ограничения допустимо. Неподтвержденное обвинение требует отдельного разбора независимо от общего эмоционального тона.
Для первого замера можно использовать AI Пиксель Тулс: сервис отслеживает присутствие бренда, тональность ответов и конкурентное окружение. Значимые для репутации формулировки затем нужно проверять по полному тексту и первоисточникам.
В режимах с веб-поиском генеративная система может находить страницы, извлекать сведения и формировать ответ со ссылками. Конкретный механизм зависит от продукта и режима. Например, Google описывает для своих ИИ-функций расширение исходного запроса на связанные поисковые запросы. Это помогает понять, почему набор ссылок в нейроответе может отличаться от привычного топа по одной фразе. Источник: документация Google.
Из этого следует практический подход: работать нужно с обнаруживаемыми сведениями о компании и проверять, изменились ли ответы после обновлений. Редактирование страницы не означает немедленного изменения модели. Она может получить другую подборку материалов, обратиться к старой версии или сформировать ответ без обращения к этой странице.
Приоритет источника я бы определял по наблюдениям: как часто он появляется в проверках, какие утверждения поддерживает, насколько актуален и можно ли исправить в нем сведения. Частое цитирование делает страницу приоритетной для проверки, но еще не доказывает ее влияние на конкретную формулировку.
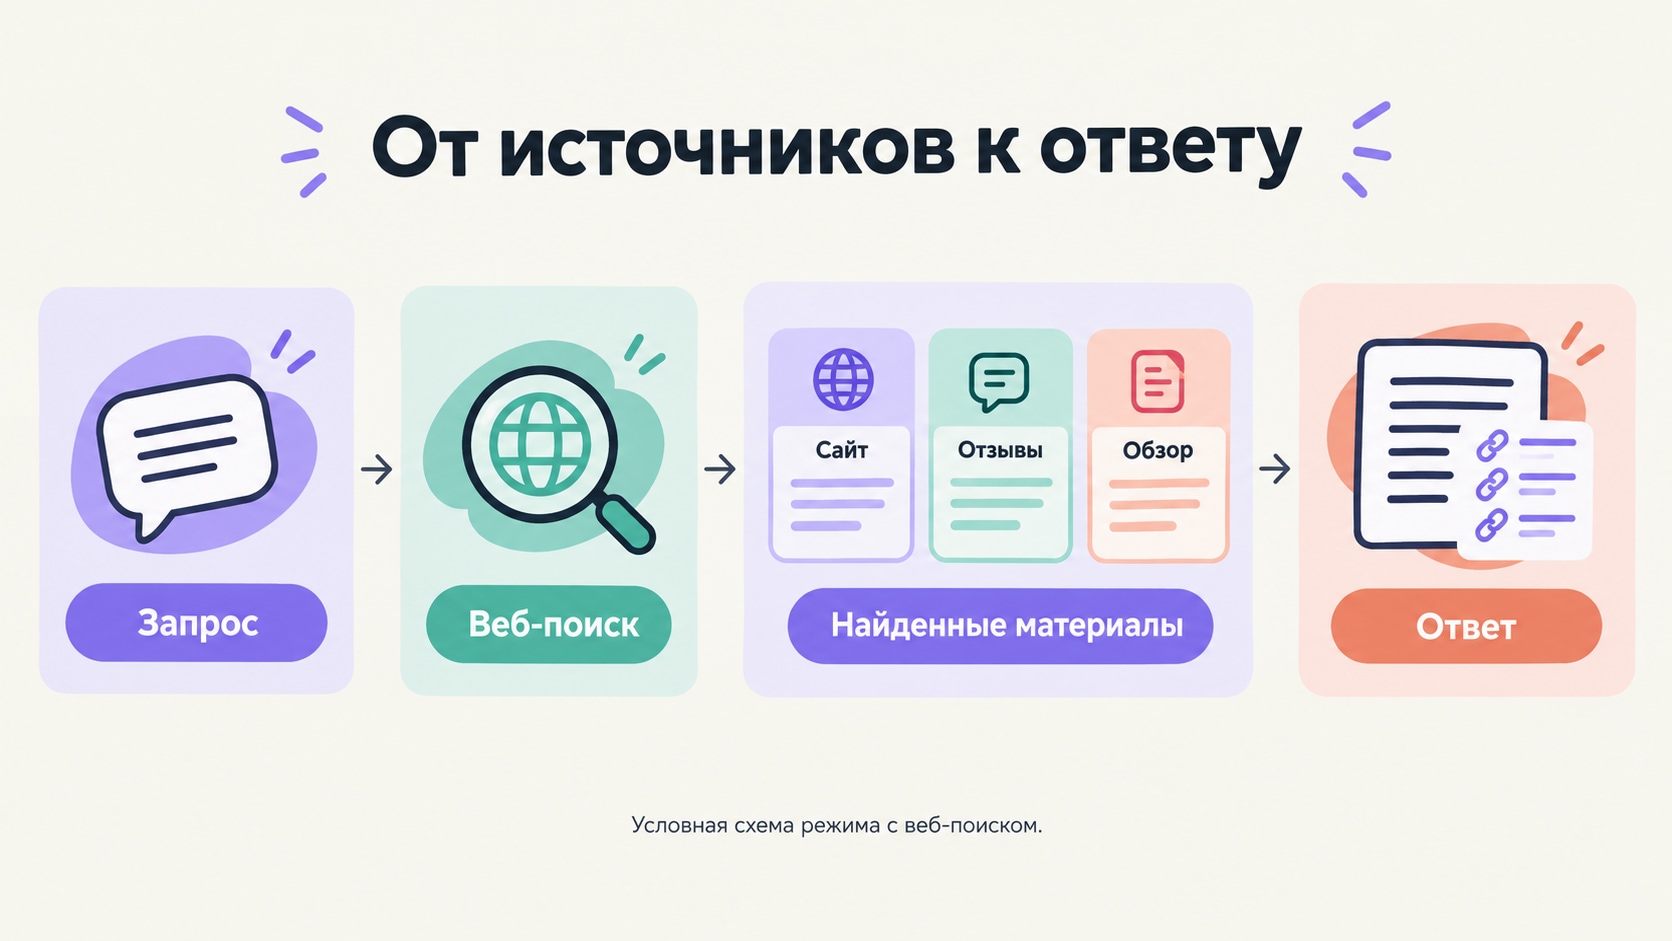
Упрощённая схема режима с веб-поиском. Состав материалов зависит от системы и запроса; показанная ссылка сама по себе не доказывает влияние на конкретную фразу.
Проверка только фразы «[бренд] отзывы» охватывает слишком узкий сценарий. Нужны несколько групп вопросов.
Знакомство и доверие: «Что известно о [бренде]?», «Какие сильные и слабые стороны у [продукта]?», «Подойдет ли [бренд] небольшой команде?».
Условия и риски: «Как устроена отмена подписки у [бренда]?», «Какие ограничения есть у тарифа?», «Что пишут о работе поддержки?».
Сравнение: «Чем [бренд] отличается от [конкурента] для задачи X?», «В каких случаях стоит выбрать альтернативу [бренду]?».
Выбор без названия компании: «Какие сервисы подходят для задачи X?», «Кого выбрать для проекта в регионе Y?». Эта группа нужна для оценки GEO: появляется ли бренд, когда пользователь еще не подсказал нейросети его название.
Провокационные вопросы вроде «почему [бренд] обманывает клиентов?» можно оставить для отдельной стресс-проверки. Их нельзя незаметно смешивать с нейтральными вопросами в общем показателе репутации: негативная предпосылка меняет условия наблюдения.
Вопросы лучше брать из обращений в поддержку, разговоров отдела продаж, отзывов и реальных сравнений с конкурентами. Список нужно разделить по продуктам, регионам и типам клиентов, если у них различаются условия обслуживания.
Единица наблюдения — конкретный ответ на конкретный запрос, полученный в определенной системе, режиме и в определенное время.
Сохраняйте формулировку запроса, полный ответ, видимые ссылки, дату, язык, регион и доступные сведения о модели. Для сравнений используйте одинаковые настройки и новые диалоги без накопленной истории, насколько это позволяет инструмент.
Для пилота можно взять, например, 20 брендовых и сравнительных вопросов и 10 категорийных, проверить их в четырех системах и сделать по три повтора. Получится 360 ответов за одну волну. Это пример бюджета проверки, а не норматив достаточной выборки.
Брендовые и категорийные вопросы анализируются отдельно. Первые показывают описание уже названной компании, вторые — ее самостоятельное появление в ответе. Три повтора помогают увидеть часть вариативности, но не превращают замер в репрезентативное исследование поведения всех пользователей.
Техническую ошибку сбора нужно отмечать отдельно. Ответ «не нашел достаточно сведений» — содержательный результат проверки, хотя данных о бренде в нем нет.
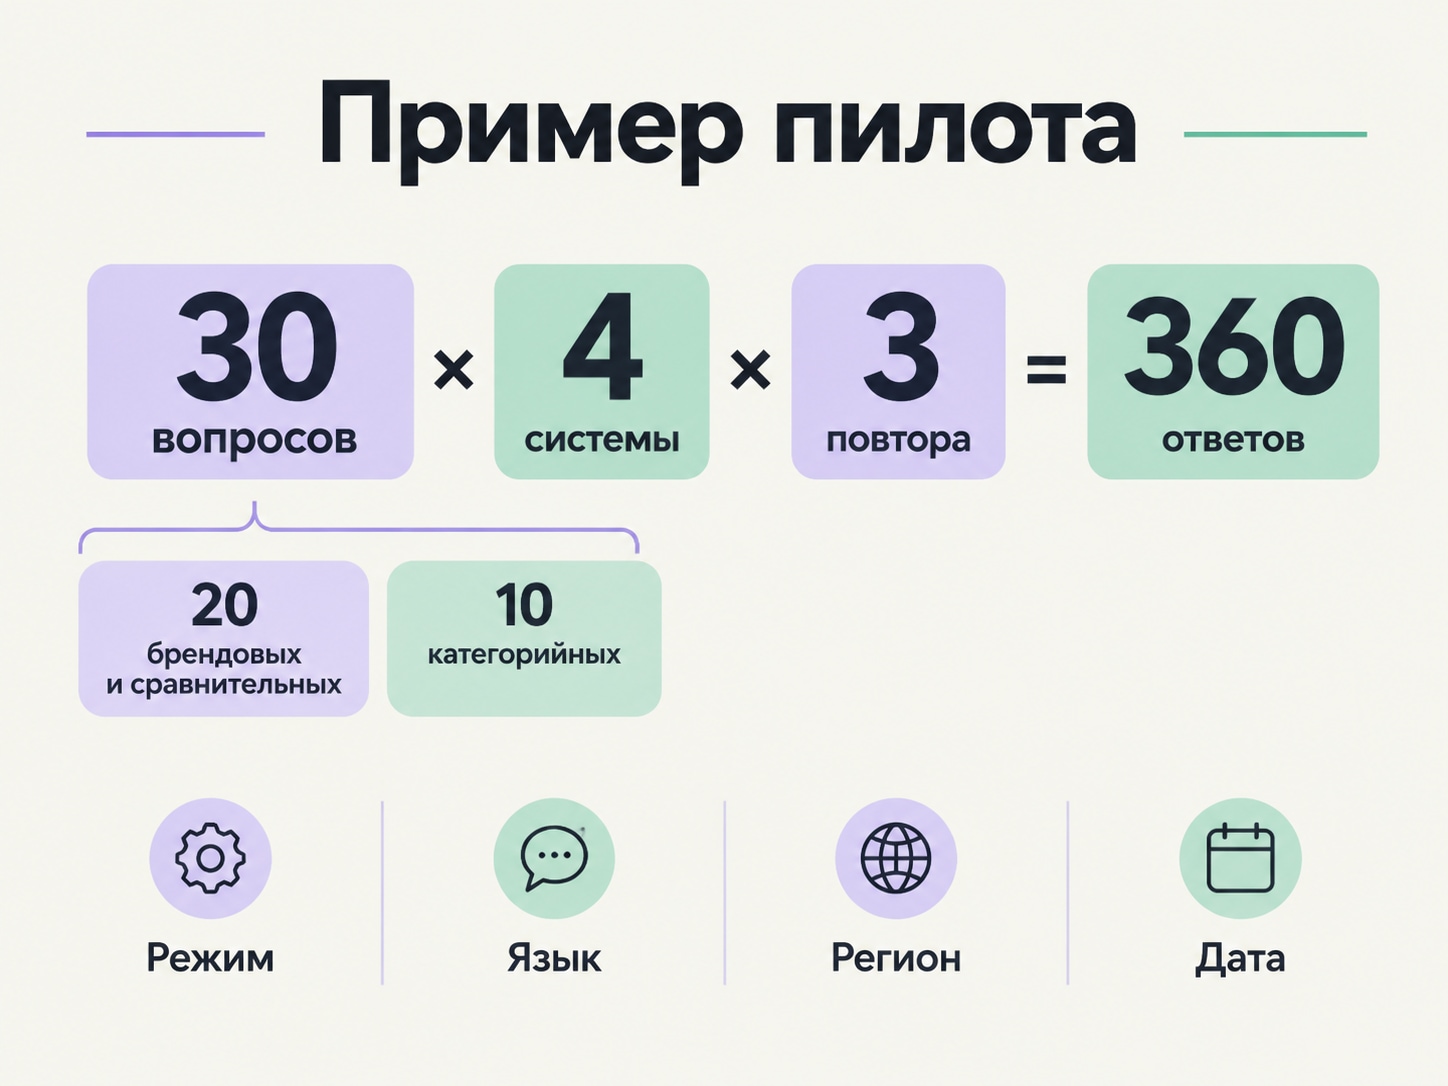
Пример объёма одного замера: 30 вопросов × 4 системы × 3 повтора. Брендовые и категорийные запросы анализируются отдельно; 360 ответов не гарантируют репрезентативность.
После сбора ответов полезнее составить реестр проблем, чем сразу заказывать новые публикации. Для каждого существенного утверждения фиксируйте:
Если ссылка не указана, так и запишите: источник не установлен. Просьба «объясни, откуда ты это взял» может запустить новую генерацию и не заменяет журнал источников исходного ответа.
Для поиска повторяющихся площадок пригодится мониторинг источников в AI Пиксель Тулс. Дальше требуется проверка самих страниц: действительно ли они содержат спорное утверждение, к какому периоду оно относится и не перепутаны ли одноименные компании.
Условный пример: нейросеть пишет, что продавец регулярно задерживает доставку. В ссылках есть старые отзывы о другом регионе, а нынешние сроки на сайте описаны расплывчато. Здесь несколько задач: уточнить географию и даты, опубликовать действующие условия, разобраться с реальными задержками и проверить повторные ответы. Серия общих текстов о надежности не устраняет эти противоречия.
Я бы начинал с утверждений, которые способны остановить покупку: недоступная услуга, ошибочная цена, неверные условия возврата, путаница между организациями. У каждой проблемы должен быть проверяемый актуальный ответ.
На собственном сайте стоит привести в согласованный вид описание компании, продуктовые страницы, тарифы, условия обслуживания и ответы на спорные вопросы. У важных сведений должны быть понятные границы: дата действия, регион, конкретный продукт или тариф. Доказательства преимуществ — результаты с описанной методикой, кейсы с условиями и проверяемые характеристики.
Затем проверьте внешние страницы, которые действительно встречались в мониторинге: карточки компании, каталоги, обзоры, интервью, отзывы. Где возможно, исправьте устаревшие сведения через владельца площадки или редакцию. С реальными претензиями нужна работа по существу: решение проблемы клиента и доступное описание того, что изменилось.
Для сайта как будущего источника важна техническая доступность. В частности, Google указывает, что страница для появления в ссылках своих ИИ-функций должна быть проиндексирована и допущена к показу в поиске со сниппетом. Отдельная специальная разметка для попадания в эти функции не требуется. Эти условия относятся к Google; переносить их на все продукты автоматически нельзя. Источник: Google Search Central.
Структурированные ответы облегчают чтение, но сами по себе не подтверждают достоверность. А множество одинаковых перепечаток одного пресс-релиза не создает множество независимых подтверждений.
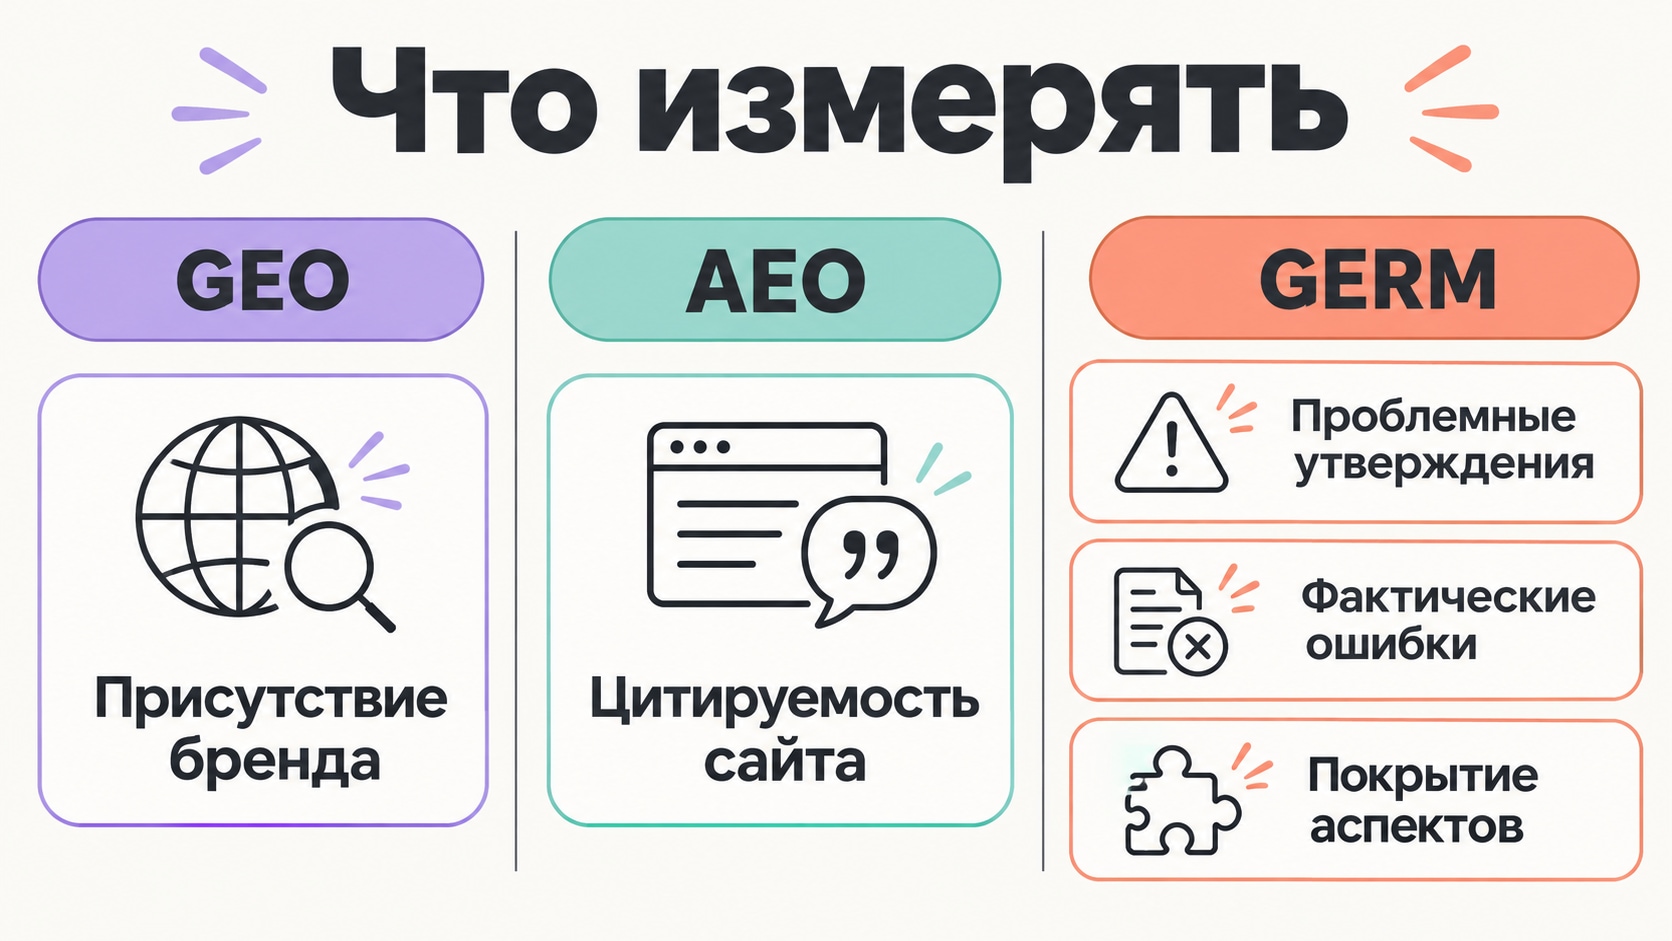
Пять показателей для отчёта. Присутствие бренда, ссылки на сайт и качество описания оцениваются отдельно; формулы и знаменатели приведены в тексте.
Ниже — рабочие определения метрик для проекта. Если готовый отчет сервиса использует другие правила, их нужно согласовать до сравнения периодов.
1. Присутствие бренда — GEO. Доля валидных ответов на категорийные запросы, в которых бренд содержательно упомянут. Если важны именно рекомендации, считайте их отдельным показателем: простое перечисление и рекомендация дают разный результат.
2. Цитируемость сайта — AEO. Доля валидных ответов в выбранном режиме с веб-поиском, где страницы вашего домена показаны среди источников. Несколько ссылок в одном ответе дают одно срабатывание этой метрики. Для режима без источников показатель неприменим.
3. Доля ответов с проблемным репутационным утверждением — GERM. Число ответов, где встречается заранее определенная проблема, деленное на число ответов с содержательным описанием бренда в том же наборе запросов. Например, отдельно считаются устаревшее условие возврата и жалобы на поддержку. Один ответ может содержать несколько аспектов, поэтому их доли не обязаны суммироваться до 100%.
4. Доля ответов с подтвержденной фактической ошибкой. Число ответов хотя бы с одной проверенной ошибкой, деленное на число ответов с содержательным описанием бренда. Недостаток доказательств нужно учитывать отдельно: непроверенное утверждение еще не является доказанно ложным.
5. Покрытие важных аспектов. Доля ответов, которые корректно раскрывают нужный факт, среди ответов на вопросы, где этот факт уместен. Например, условия возврата оцениваются в сценариях о возврате, а не во всей выборке.
Для тональности можно дополнительно использовать категории «положительная», «нейтральная», «смешанная» и «отрицательная». Отсутствие данных о компании хранится отдельным статусом. В важных ответах я бы проверял автоматическую разметку вручную, особенно отрицания и смешанные оценки.
Условный пример: в первом замере из 100 валидных ответов бренд содержательно описан в 80, негатив есть в 40. Во втором замере бренд описан в 20 ответах, негатив есть в пяти.
Доля негативных ответов среди описаний бренда снизилась с 50% до 25%. Одновременно присутствие сократилось с 80% до 20%. По этим данным нельзя заключить, что репутационная задача решена: компания стала заметно реже появляться в ответах.
Поэтому вместе с долей проблемных описаний показывайте число упоминаний, число валидных проверок и долю ответов без данных. Сравнивайте одинаковые группы запросов по каждой системе. Если меняется состав запросов или моделей, сохраняйте отдельный отчет по сопоставимой части.
Для повторных замеров можно использовать AI Пиксель Тулс для оценки динамики: сопоставлять присутствие бренда, тональность и источники. Исправление конкретного утверждения подтверждается чтением ответов и проверкой фактов.
Изменение после публикации материала еще не доказывает ее причинного эффекта. Одновременно могли обновиться модель, поисковые результаты или обсуждение компании. Журнал правок и несколько последовательных замеров дают более полезную картину, чем один удачный скриншот.
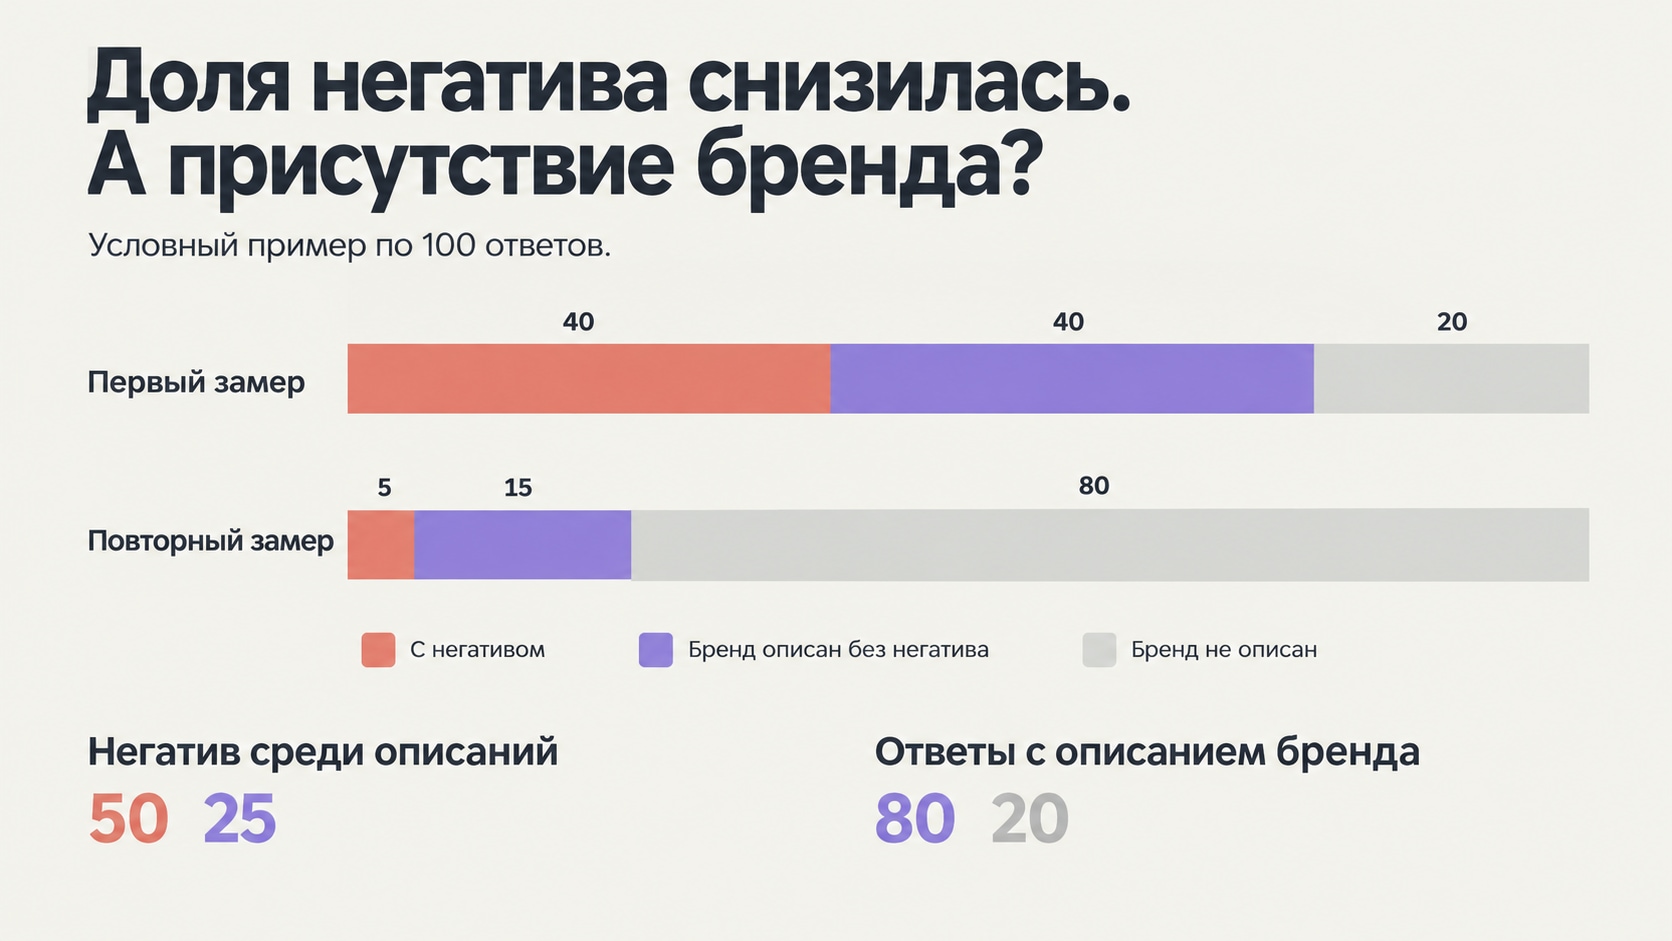
Условный пример, по 100 валидных ответов в каждом замере. Доля негатива среди описаний бренда снизилась с 50% до 25%, одновременно доля ответов с описанием бренда сократилась с 80% до 20%. Это не результаты реального проекта.
Первая неделя: собрать вопросы клиентов, настроить первый замер и выделить повторяющиеся ошибки и репутационные темы. Выбрать приоритеты по серьезности последствий, частоте появления и возможности исправления.
Вторая неделя: подтвердить факты у продуктовой команды и поддержки, подготовить актуальные страницы и передать запросы на исправление внешним площадкам. Для каждой задачи назначить владельца.
Третья неделя: опубликовать обновления, проверить их доступность и сохранить даты изменений. Если проблема связана с качеством услуги, вести исправление вместе с операционной командой.
Четвертая неделя: повторить замер по прежним правилам и разобрать изменения по конкретным утверждениям. Месяц здесь — длительность первого рабочего цикла. Срок появления обновленных сведений в ответах заранее не гарантирован.
В отчете руководителю полезно показать, какие ошибки устранены, какие темы продолжают воспроизводиться и от каких источников зависит следующий шаг. Переходы, обращения и продажи можно отслеживать дополнительно, но рост позитивной тональности сам по себе не доказывает рост конверсии или LTV.
Рабочая единица управления в GERM — конкретное утверждение о бренде: где оно появилось, чем подтверждается, что нужно исправить и как выглядит повторная проверка. Такой подход связывает репутационный мониторинг с задачами контента, PR, поддержки и продукта. GEO показывает присутствие бренда, AEO — присутствие сайта в источниках, а GERM помогает оценить, насколько корректное представление о компании получает клиент.
Комментариев пока что нет
Входим в число лучших компаний России в сферах интернет-рекламы и разработки сайтов по результатам самых авторитетных рейтингов

Нужна помощь с сайтом? Заполните форму, и наши менеджеры проконсультируют вас уже сегодня!


Уникальный тариф «Оборот», где доход агентства больше не зависит от визитов и позиций вашего сайта, а привязан исключительно к росту оборота вашей компании.
Тариф, который хотели сделать многие, но реализовали только мы.
Зарегистрироваться, используя e-mail: